近年積極投入 AI 領域的 Meta,繼 5 月發表多個大型語言模型後,如今又發表了能夠翻譯、轉錄近 100 種語言的 AI 模型 SeamlessAlign,並且同樣以開源的方式提供給所有人使用。
Meta 端出全新 AI 模型 SeamlessAlign,能辨識近 100 種語言!
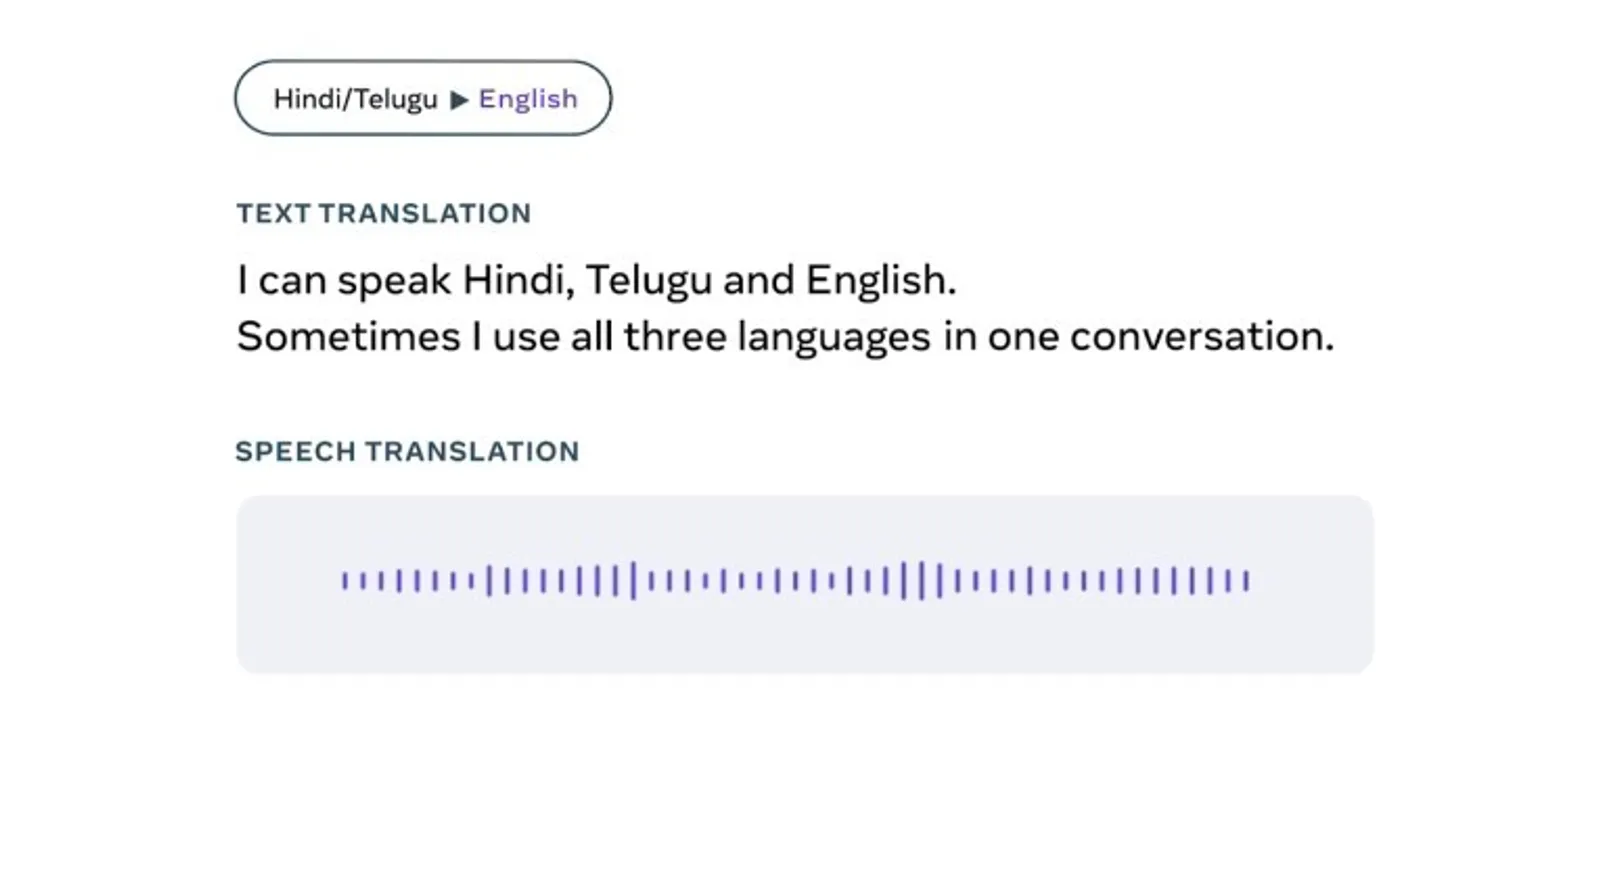
Meta 在聲明中表示,SeamlessM4T 的誕生代表著基於 AI 的語音翻譯、語音轉文字領域的重大突破。按照 Meta 的說法,SeamlessM4T 可以提供:
1.辨識近 100 種語言的語音
2.支援近 100 種語言的語音轉文字
3.語音翻譯技術,可支援近 100 種輸入語言及 36 種輸出語言
4.近 100 種語言的文字轉文字技術
5.文字轉語音技術,可支援近 100 種輸入語言及 35 種輸出語言
雖然像哆啦A夢裡翻譯蒟蒻般便利的道具還未出現,不過 Meta 聲稱 SeamlessM4T 會是人們能夠更便利溝通的重要一步,這個模型無須其他模型協助,即可辨識各個不同語言,透過單一系統的方法減少了翻譯錯誤及延遲,並提升了效率及品質,讓不同語言的人能夠更有效率地溝通。

Meta 執行長馬克.祖克柏(Mark Zuckerberg)表示,「隨著時間,我們會將這些 AI 翻譯與轉換技術成果整合到 Facebook、Instagram、WhatsApp、Messenger 及 Threads。」
身為一間社群媒體公司,Meta 已經投入翻譯技術多年,外媒《TechCrunch》就形容 SeamlessM4T 是傳承自 Meta 過去所研發的翻譯模型 No Language Left Behind,以及通用語音翻譯工具(Universal Speech Translator)──一個少數支援台語的語音翻譯系統。
而 SeamlessM4T 也是建立在今年5月發表的大規模多語言語音(Massively Multilingual Speech,簡稱 MMS)大型語言模型上,該模型可轉換超過 1,100 種語言,並可辨識 4,000 種口語語言。
Meta 用大量公開資料練成,比當前模型更能應付不完美的狀況
且如同前幾次公布 AI 領域進展的作法,Meta 宣布開放研究人員及開發人員基於 SeamlessM4T 進行開發與研究,同時將公開訓練時所用數據集 SeamlessAlign。Meta 聲稱這是目前最大的公開多模式翻譯數據集,將語音與文字校準過的資料高達 44.3 萬個小時,並且還有 2.9 萬小時的語音對語音校準資料。
Meta 指出,他們從網路上抓取了數百億個句子,以及約 400 萬小時的語音資料作為最初的材料。雖然 AI 訓練資料近幾個月引發大量爭議,許多創作者反彈科技公司逕自使用他們的心血,並要求為此付費,Meta 強調他們所有資料都沒有版權問題,主要來自開源或者授權的資料來源。
也因為如此龐大的資料,Meta 聲稱 SeamlessM4T 在測試艱難條件的表現時結果更佳,與目前最好的模型相比, SeamlessM4T 在有背景噪音、說話者換人的情況下準確度要分別高出 37% 及 48%。
不過 SeamlessM4T 仍有些小問題存在,例如在看不出性別訊息時有 10% 的情況更喜歡翻譯成男性,Meta 認為這可能是因為訓練資料中男性出現得較多。同時在個別語言中,有時 SeamlessM4T 翻譯時會較容易出現有害言論,涉及性取向及宗教時偶爾也會出現問題。
Meta 聲稱,SeamlessM4T 的公開測試版本將會有針對輸入及輸出語音的篩選機制,會過濾掉不適宜或有害的內容,只不過 Meta 開源提供研究人員及開發者的版本中,並沒有包含這項防護措施。
Meta 指出,他們希望透過這項技術幫助不同語言的人們聯繫彼此,並且將以此為基礎探索這個基礎模型如何創造新的通訊能力,「最終讓我們更接近一個所有人都能被理解的世界。」
資料來源:TechCrunch、Meta
(本文轉載自《數位時代》)