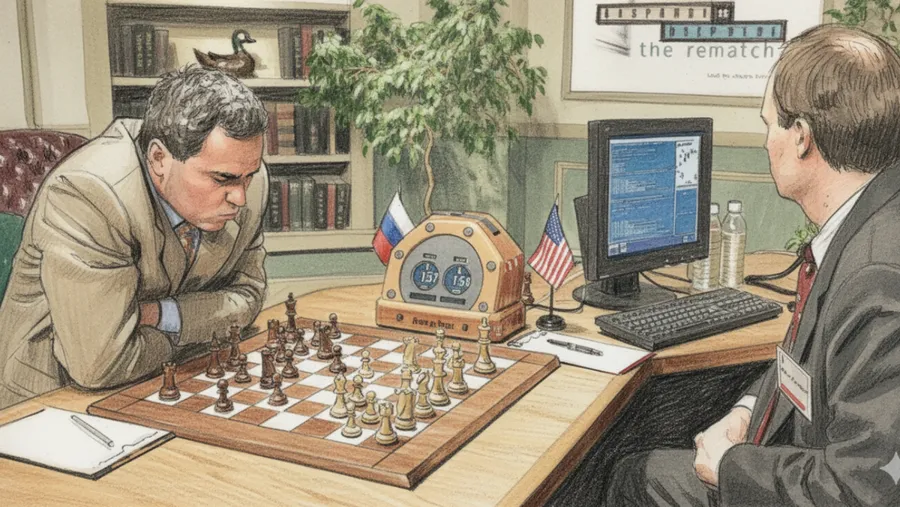
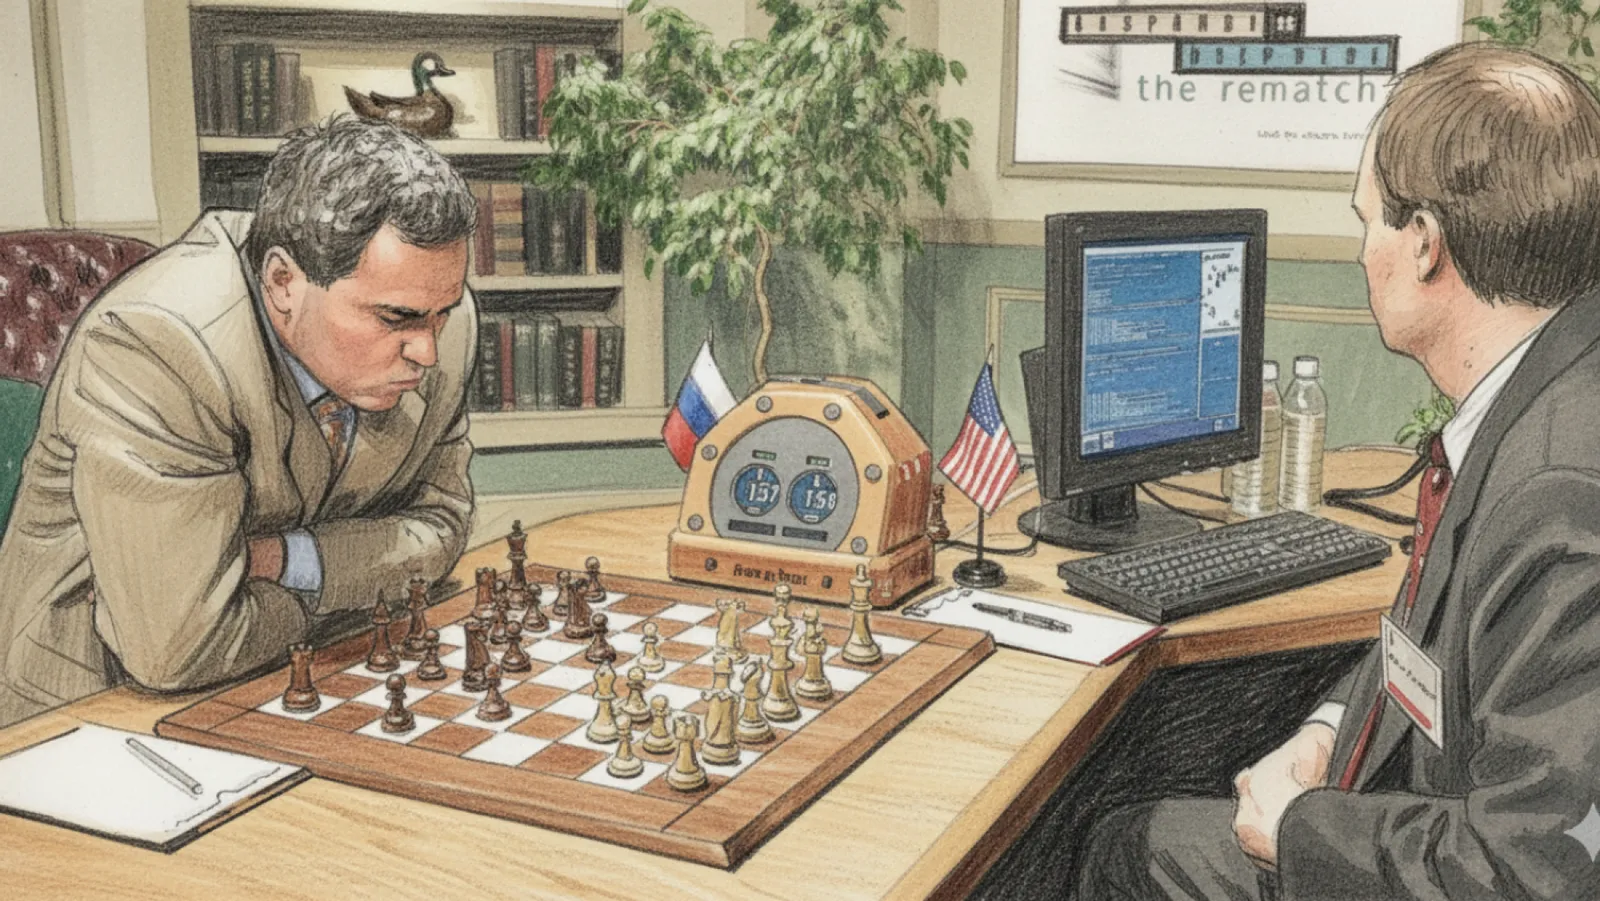
1997 年,IBM 深藍電腦(Deep Blue)擊敗當時俄國西洋棋王卡斯帕羅夫。這是人類歷史上 AI 首次在專項技藝上戰勝全球職業冠軍。促成這場劃時代戰役的關鍵人物,正是台籍電腦科學家、時任 IBM 專案主管的許峰雄博士,其專長以半導體晶片設計見長,他想出和那個年代完全不同的電路設計方法,使棋步運算效率高出千倍以上。
許峰雄博士的生涯,從台灣大學電機系對超大型積體電路(VLSI,全稱為 Very Large-Scale Integration)設計的熱忱出發,意外踏入電腦棋藝的研究領域,並在 12 年的耕耘後,成就了 Deep Blue 的傳奇。
以下 Q 為數位時代總編輯王志仁提問,A 為深藍電腦之父許峰雄博士的回答。內容圍繞許博士的個人學術歷程,並聚焦於 AI 發展的關鍵里程碑。從 Deep Blue 到 AlphaGo,再到當前的生成式 AI,解析他對當前技術與產業前景的獨到見解。
Q1:在台灣 AI 研究尚未起步的年代,是什麼原因讓您最終選擇了 CMU 的電腦科學系?您又是如何看待西洋棋這項興趣?
A:我當初赴美是為了攻讀 VLSI 設計,這源於當年史欽泰學長在台大的演講啟發,他提及這是接下來最基本且重要的事。因此,我申請的美國學校大部分是電機系,而 CMU(卡內基梅隆大學)則是我唯一申請的電腦科學系(Computer Science)。最終選中 CMU 的原因是:一來是孔祥重教授在該校有一個 VLSI 設計組,二來 CMU 在 AI 研究上享有盛名,有 Newell 和 Simon 這樣元老級的電腦科學學者。
當時,台灣的 AI 研究尚未起步,網際網路也不像現在這般發達,那時我對下棋略有興趣,在學時便將台大圖書館內所有與下棋相關的資料都研究過一次。根據當時的資訊,所有最好的程式也只達到所謂的 Class C。Class C 是很弱的程式,與世界冠軍相去甚遠,所以當時我並沒有預期自己能做出贏過世界冠軍的電腦。甚至,我也沒打算要做電腦西洋棋,因為看起來還是沒什麼搞頭。
直到我進入 CMU 才發現,電腦棋藝界在 70 年代末期到 80 年代初期已發生重大轉變:人們發現將程式搬上超級電腦或專用硬體加速運算後,棋力會大幅提升。這引發了一場「算力競賽」,與現在所有 AI 公司都在搶購 NVIDIA 晶片、增加算力的情況如出一轍,歷史正在重演。
Q2:因何契機投入電腦棋藝研究,並如何運用 VLSI 技術來設計晶片,達成遠超對手數十倍的算力提升?
A:就讀 CMU 研究所第二年時,有位教授 Hans Berliner 想要做電腦西洋棋的機器,他先找人做產生棋步的運算單元,用了 64 晶片,10 萬棋步。之後再找我協助設計一個同樣 64 晶片、負責局面評估(Evaluation)的硬體。我仔細分析後認為,這在電路架構上並不合理,因為評估需要大量累加運算,多晶片之間的通訊成本太高。我想到既然我的專長是 VLSI,為什麼不用單一晶片來解決這個問題?
我回頭重新研究如何產生棋步(Move Generation)。計算後發現,如果能將機器的速度加快 1,000 倍,理論上就有機會與世界冠軍抗衡。我進一步思考,Move Generation 這個以位元層級操作為主的運算,可以被設計成一個高效的單一晶片。
在孔祥重教授(為許博士的指導教授)的鼓勵下,我花了六個月設計出第一個 Move Generator 晶片,它的速度達到每秒 300 萬棋步,比當時最快的 64 晶片設計(10 萬棋步/秒)快了 30 倍,而面積卻僅有 64 分之一。這項能進行平行運算的晶片設計,成為 Deep Blue 的關鍵基礎,也成為我的博士論文證明之一。
Q3:1997 年深藍贏得西洋棋比賽、2016 年 AlphaGo 贏得圍棋冠軍,您認為兩者背後最根本的技術分野為何?
A:看到 AlphaGo 在 2016 年贏得圍棋冠軍,我並沒有感到驚訝。從 1997 年到 2016 年將近 20 年的時間,依照摩爾定律(Moore's Law)的算力增長,電腦棋力提升是遲早的事。
但從 Deep Blue 到 AlphaGo 之間,發生了極為重要的一件大事:深度學習(Deep Learning)。深度學習的關鍵意義,並不在於解決了某個單一難題,而是它帶來了一套新的演算法(Algorithm),能高效地在像 NVIDIA 這樣的平行處理晶片上快速運行。這使得許多過去不能做的任務,現在忽然可以實現。深度學習問世後,整個 AI 領域發生了實質的飛躍(Content Leap),比如:語音辨識、電腦視覺、語言處理模型的準確度全部大幅提升至 97%、98%。
現在的生成式 AI,某種程度上就是深度學習加上大型語言模型(LLM)的成果。有了語言模型,電腦開始可以聽、讀、寫,它能掌握人類過去所有的知識。雖然電腦的理解不見得完全正確,需要再三確認,但它提供了一個工具,讓人們的工作能力產生了巨大的飛躍。
Q4:從半導體切入 AI 發展,您認為在這一波浪潮中,半導體晶片扮演了什麼不可或缺的角色?
A:基本上,我們永遠無法擺脫半導體,你必須擁有計算能力(You must have the computation power),否則什麼事都做不了。長遠來看,摩爾定律若能持續,成本會越來越低,計算能力也會越來越便宜。如果一個問題可以用算力來解決,那通常會是一個簡單且有效的解決方案。因此,運算能力的需求一定會持續下去,硬體基礎依舊關鍵。
NVIDIA 的成功是一個縮影。他們本來專注於圖形運算,這本身就是一種平行運算。他們當時做了一件非常聰明的事——開發了 CUDA(平行運算平台和程式設計模型),讓晶片變得容易編程。當深度學習的演算法出現時,NVIDIA 成為了唯一擁有這麼好軟體環境的晶片,因此很快被整個 AI 領域採用,加速了技術的普及。
Q5:當前 AI 熱潮,許多人擔憂是另一次「泡沫」,您認為這波生成式 AI 與過去相比有何差別?
A:生成式 AI 的成功是多重因素疊加的結果:半導體的持續進步(算力基礎)。深度學習的關鍵演算法。全球資訊的積累與普及:網際網路(WWW)的普及與手機、電腦的使用,產生了巨大的海量數據。沒有這些數據,許多事情在 Web 時代之前是無法發生的。
我認為,這一波 AI 跟過去最大的不同在於:這次的技術方向與基礎是真實且紮實的,不是純粹的炒作(hype)。電腦現在真的開始理解很多以前做不到的事情,這是巨大的差別。此外,ChatGPT 的出現,讓 AI 走向了民主化。一般人,即使不是電腦科學家,也可以利用 AI 來做事,讓這些強大的工具普及化。
Q6:在 AI 時代,您對持續學習有什麼建議?您目前最感興趣或正在追問的技術領域是什麼?
A:最重要的,是對什麼東西有興趣。當你有興趣時,你就會願意花時間多看、深入研究。久而久之,你看待事物的角度就會比別人更深刻,自然能產生與眾不同的看法。我在台大時,透過自學成為校內最了解電腦棋藝文獻的人,這證明了持續的自我驅動和自學能力是經歷技術變革的不變經驗。
至於我目前感興趣的領域,是 EUV(極紫外光微影)波長是 13.5 奈米,宣稱的 2、3 奈米製程都是透過技術達成。我一直在思考,從根本上來說,為什麼我們不能用類似噴墨(ink jet)的方法,直接用更小的光阻劑顆粒進行直寫,從而做出比 13.5 奈米更小的線路?這不僅能繞過光源問題,也可能大幅降低目前 EUV 極高的電力消耗。
當然,「為什麼不能做?」尚停留在根本性追問。端看我對該題目的興趣強度,再來決定是否深入研究。
(延伸閱讀|EP 258. 史上首次AI打敗人類天才,背後推手如何評價當前泡沫疑慮? ft.深藍電腦之父許峰雄)
(本文初稿為 AI 整理)