為讓文章能跨產業、跨情境閱讀,我在舉例上刻意採用「最小可理解」的示意寫法。這些例子主要用來幫助能快速掌握用戶特徵 360 四大維度的設計邏輯。實務落地,仍需依產業特性、服務型態、資料可得性與商務目標來進行規劃與設計(有相關議題的同好們,期待能一起交流)。
從我在甲乙方現場的實務觀察,當開始使用 CDP 設計個人化體驗時,最需要先被定義的一件事就是: 我們是用什麼方式理解用戶? 在導入 CDP 初期時,起手式都是很直覺的從經年累月的業務邏輯,並透過打「標籤」的方式來定義用戶樣貌(我自己也是),但隨著營運迭代的累積,我們就會開始碰到以下兩種型態的狀況:
第一種我稱作為 「標籤雜亂」 :不同營運單位(甚至同一個單位的不同專案)依據各自的業務邏輯,持續新增標籤來進行個人化體驗行銷。而隨著時間的累積,CDP 或是自家的標籤系統,開始變成一座雜亂的標籤倉庫,相似&同義標籤越來越多、維護成本上升、運算成本上升,以及對於不同標籤的定義,只有當初建立標籤的同事知道怎麼用的狀況。
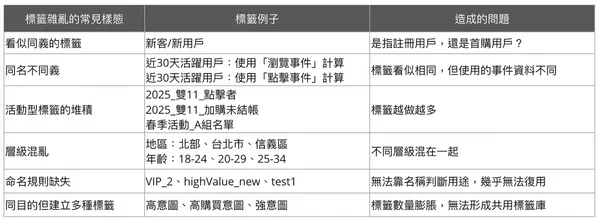
第二種是 「缺乏標籤架構策略」 :即使我們都意識到標籤雜亂的狀況,又或是一開始就知道需要有秩序的來設計用戶標籤,但實務上常常卡在缺少一套基本框架 ,來梳理出一套有商業邏輯的標籤架構,最後結果就是標籤越做越多,且越難轉換成可複用的資料資產。
(延伸閱讀|買了 CDP 卻用不出價值?掌握這四大導入關鍵,才能讓工具真正發揮效益)
如何架構一套能讓標籤長出秩序的框架?
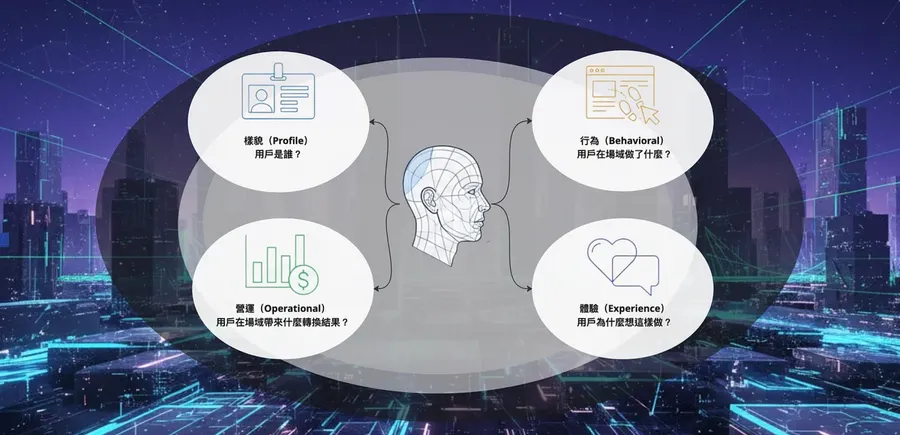
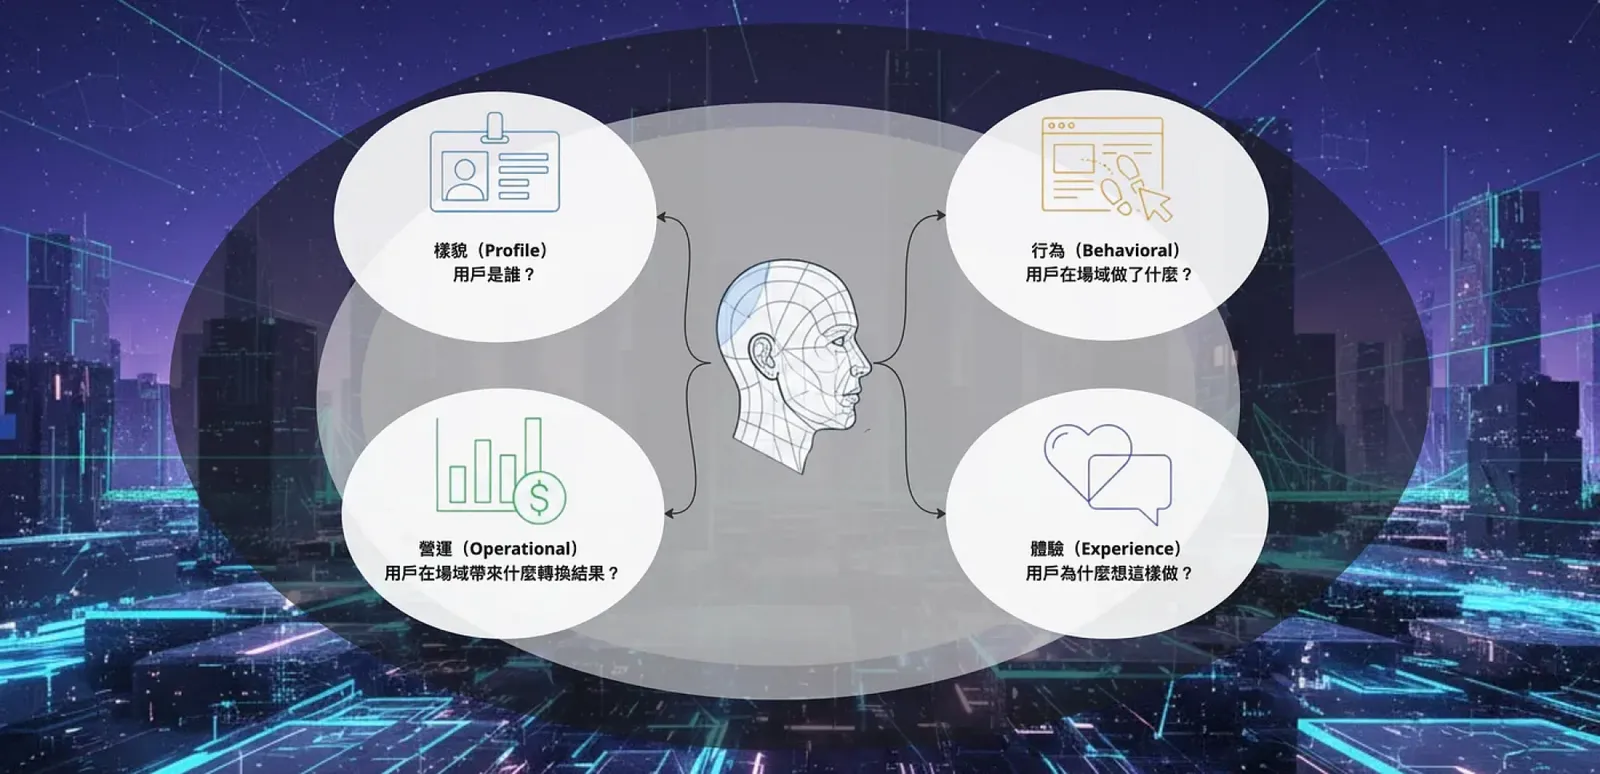
在這之前,最需要先被定義的一件事是: 我們是用什麼方式在理解用戶? 因為所有的個人化體驗不論是分眾、推薦、行銷自動化,本質上都是在做同一件事: 用某種「對用戶理解的方式」去決定下一個最合適的用戶體驗互動。 因此,要把一位用戶理解到足以支撐個人化體驗,其實離不開這四個最根本的方向,我稱之為 PBOX Framework:樣貌(Profile)、行為(Behavioral) 、營運(Operational)、體驗(Experience)。我們能夠透過這四大維度,來把用戶標籤整理成可治理、可複用,並讓「用戶資料」轉變成「用戶資產」的“用戶特徵 360”。
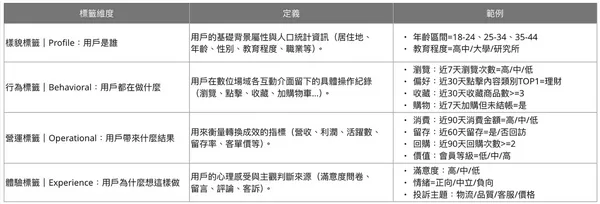
樣貌(Profile):用戶是誰?
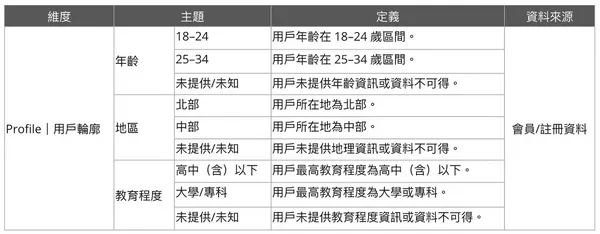
樣貌維度是用來回答「用戶是誰?」,它是最基礎的維度。像是年齡層、地理分布、教育程度……等,這些人口統計資訊,就是描繪用戶基本輪廓的基本資料。而樣貌維度能用來觀察,品牌的核心受眾輪廓,以及渠道投放、經營內容、舉辦活動,所吸引來的用戶樣貌。
行為(Behavioral):用戶在場域做了什麼?
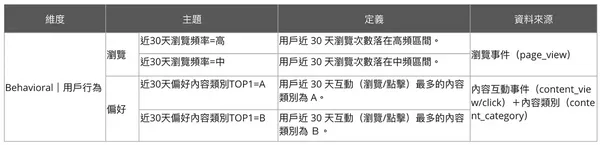
行為維度回答的是「用戶在場域做了什麼?」。行為資料能把互動過程中的細節攤開來看,成為企業預測消費意圖、優化轉換體驗的重要基礎。而在刻畫用戶行為特徵時,重點並不是把所有行為都做成標籤,而是 收斂出最關鍵、最可複用的行為訊號 。
營運(Operational):用戶在場域帶來什麼轉換結果?
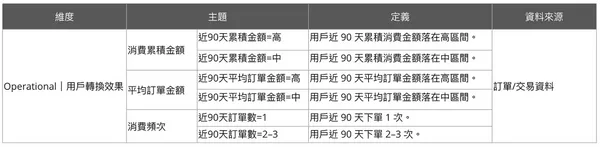
營運維度回答的是「用戶在場域帶來什麼結果?」。它能最直接的表現出「 用戶是否產生實際轉換,以及帶來多少商業價值 」。透過營運資料,企業能掌握顧客的實際購買行為,包括 購買品類、購買頻率、客單價 等指標。而營運資料是用來衡量用戶整體價值的重要來源,例如透過終身價值的計算,能評估不同用戶對企業的貢獻,進而調整會員經營的資源投入與分群方向。
體驗(Experience):用戶為什麼想這樣做?
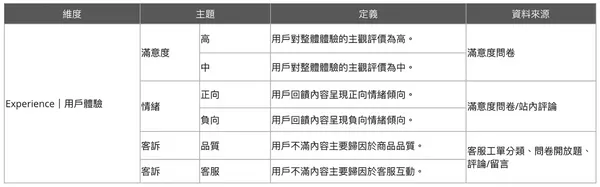
體驗維度回答的是「用戶為什麼想這樣做?」。 它的價值在於補上最關鍵的一塊: 用戶的主觀感受與背後動機,顯示用戶對品牌忠誠度的狀態。 從標籤角度來看,我們能把顧客的聲音轉換成可治理的標籤,讓整體在用戶經營上能用同一套語言理解用戶的感受。但實務上,這一層的資料是相對難被整進標籤體系內,目前還尚未看到好的應用案例,我也持續在進行中。
用戶特徵 360:從用戶資料轉變成用戶資產
當我們透過 Profile / Behavioral / Operational / Experience 完成標籤收斂後,我們可以得到一張可被共同使用的 用戶特徵大表 ,我把它稱為 「用戶特徵 360」:它會是一套 理解用戶的共通語言 ,讓個人化、自動化行銷、推薦內容、服務與營運決策都能站在同一個框架上運作。
「用戶特徵 360」的價值在於它把原本分散的用戶標籤,收斂成可解釋、可對齊、可持續更新的特徵結構。這張「用戶特徵大表」它像是一個企業用來「 理解用戶的介面層 」。任何單位要做分眾、要設計旅程、要決定觸發條件、甚至要用在 AI 內容生成與推薦時,都能透過這張表上取用同一套特徵。好處是,我們得到的是一種「可解釋性」,讓我們知道每一次的個人化互動是根據哪一類特徵判斷。
最後當「用戶特徵 360」被建立起來, 用戶資料才真正開始資產化 ,用戶標籤不再依附於單一使用者中或單一團隊中,而是能跨場景複用、能被治理、能隨著時間迭代,並幫助我們去 管理與建立長期累積的用戶資產,並支撐更有溫度的顧客體驗 。
(延伸閱讀|實體活動走向數位化!整合購票、消費、應援,一次性交易如何成為「長期關係資產」?)
建構用戶特徵 360 是不迷人的髒活,但它決定體驗的深度
用戶底層資料工程,包含了:設計架構、定義欄位、收斂標籤、資料來源、領域知識萃取……等流程。實務上,這項工作一點都不迷人,甚至就是髒活(如果你剛好正在進行這件事,這個經驗將能在未來滋潤你對用戶資料理解的深度),但它對我來說是一件重要的事。歸根究底不論在個人化體驗與 AI 體驗,最後都得建立在同一件事上, 我們是否有一致性、可解釋、可複用的方式去理解用戶,最後真的讓用戶感受到被理解 ,而「用戶特徵 360」就是一套需要長期運作的基礎建設 ,讓體驗不靠靈感,讓 AI 推薦可以有解釋性,讓體驗溫度可以被設計出來。
後記:那些還沒展開討論,但同樣重要的事
這篇文章談的是「用戶特徵 360」的架構收斂,以及如何透過 PBOX Data 把標籤整理成可治理、可複用的資料資產。以下幾點,是本文還尚未展開討論的題目:
關於標籤本身:
-
標籤更新頻率:特徵標籤是即時更新、每日批次、還是每月計算一次?
-
標籤新鮮度:過去 7 天與過去 180 天的意義完全不同,「時間維度」要如何依據商業邏輯來設計?
-
標籤屬性類型:先大概說明標籤本身還能區分不同種的類型:
・靜態標籤:如地區、教育程度
・動態標籤:近30天消費≥3
・演算標籤:預測流失
・領域標籤:來自熟悉領域的現場專家所定義的標籤
・自動化標籤:透過模型所產生的標籤
關於標籤的延伸應用:
-
標籤交集應用:當用戶特徵 360 建構完成後,標籤交集邏輯就能被規模化使用,例如:低消費 × 高瀏覽 × 價格敏感。
-
推薦排序與個人化權重:有了用戶特徵 360後,將成為推薦排序中的權重依據。
-
模型的應用:例如自動增加用戶的檢索條件,訓練模型時的結構化特徵來源。
(本文經 Hsin Chih Lai 授權轉載)